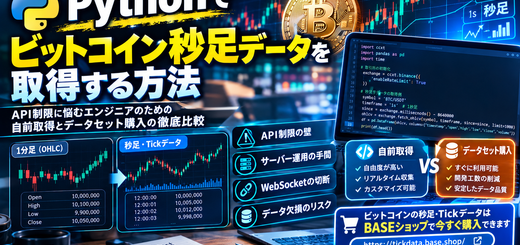
Pythonでビットコイン秒足データを取得する方法|API制限と自前収集の問題を解説
Pythonでビットコインの自動売買システムを開発していると、いずれ必要になるのが過去の市場データです。
特に、
- バックテスト
- 売買ロジックの検証
- 約定シミュレーション
- スリッページ検証
- Tick単位の価格分析
- 秒足データによる高速売買の検証
などを行う場合、1分足だけでは情報が不足することがあります。
そこで「Pythonでビットコインの秒足データを取得したい」「TickデータをAPIから集めたい」と考えることになります。
しかし、ここで問題になるのが取引所APIの過去データ取得制限です。
リアルタイムデータをWebSocketで受信することと、数週間・数か月・数年分の過去データを取得することは、まったく別の問題です。
本記事では、Pythonを使ってビットコインの秒足・Tickデータを自前収集する基本的な方法と、その際に発生するAPI制限、サーバー運用、データ欠損対策などを整理します。
さらに、最初から完成済みのデータセットを購入して利用する方法についても比較します。
ビットコインの秒足データをPythonで取得する方法
Pythonで取引所の市場データを取得する方法は、大きく分けてREST APIとWebSocketの2種類があります。
REST API
REST APIは、HTTPリクエストを送って必要なデータを取得する方式です。
例えば、PythonからAPIを呼び出してローソク足を取得する場合、概念的には次のようなコードになります。
import requests

url = "https://example.com/api/candles"

params = {
    "symbol": "BTC/JPY",
    "interval": "1m",
    "limit": 1000
}

response = requests.get(url, params=params)
data = response.json()

for candle in data:
    print(candle)
実際のURL、パラメータ、レスポンス形式は取引所によって異なります。
REST APIのメリットは、必要な期間のデータをリクエストして取得しやすいことです。
一方で、過去データについては、
- 1回あたりの取得件数
- 取得可能期間
- レートリミット
- 利用可能な履歴範囲
などの制限があります。
つまり、
「APIがある=何年分でも自由に過去データを取得できる」
というわけではありません。
WebSocketでリアルタイムデータを収集する
Tickデータやリアルタイムの約定データを継続的に取得したい場合、WebSocketが利用されることがあります。
Pythonでは、例えばWebSocketクライアントを使って接続し、受信したデータを保存する仕組みを構築できます。
概念的には以下のような構造です。
import websocket
import json

def on_message(ws, message):
    data = json.loads(message)

    print(data)

ws = websocket.WebSocketApp(
    "wss://example.com/stream",
    on_message=on_message
)

ws.run_forever()
実際にはこれだけでは実用的なデータ収集システムにはなりません。
例えば、
WebSocket接続
      ↓
Tick受信
      ↓
データ検証
      ↓
タイムスタンプ処理
      ↓
CSV / DB保存
      ↓
接続監視
      ↓
切断
      ↓
再接続
      ↓
欠損期間の確認
      ↓
REST APIなどで補完
という処理が必要になります。
ここからが、Pythonでのビットコイン 秒足データ収集の本当の難所です。
Pythonで秒足・Tickデータを自前収集する難しさ
Pythonそのものは、Web APIやWebSocketとの接続が得意な言語です。
そのため、「データを取得するだけ」なら、それほど難しくありません。
問題は長期間、欠損なく、壊れずにデータを集め続けることです。
APIのレート制限
取引所APIには、多くの場合リクエスト数に関する制限があります。
例えば、
1回目 → 成功
2回目 → 成功
3回目 → 成功
...
と取得していっても、短時間に大量のリクエストを送れば制限に引っかかる可能性があります。
そのため、
import time

for request in requests_list:
    response = get_data(request)

    time.sleep(0.2)
のようにリクエスト間隔を調整したり、HTTPステータスコードやAPI固有のエラーを処理したりする必要があります。
さらに、
- HTTP 429などのレート制限
- タイムアウト
- 一時的なサーバーエラー
- DNS障害
- ネットワーク切断
なども考慮する必要があります。
WebSocketの切断問題
WebSocketを利用する場合は、さらに別の問題があります。
例えばサーバーを24時間稼働させているとしても、
09:00 → 正常
10:00 → 正常
11:17 → 接続切断
11:18 → 再接続
ということが発生する可能性があります。
問題は11:17〜11:18のデータです。
そのまま保存してしまえば、バックテスト用データに欠損が発生します。
したがって、
while True:
    try:
        connect_websocket()
    except Exception:
        time.sleep(5)
        reconnect()
のような再接続処理だけでは不十分です。
再接続した後、
「切断中に何が起きていたのか」
を別の方法で補完する必要があります。
データ欠損を検出する仕組みも必要
例えば秒足データなら、
12:00:00
12:00:01
12:00:02
12:00:03
12:00:04
と連続していることが期待されます。
ところが、
12:00:00
12:00:01
12:00:02
12:00:08
12:00:09
となっていれば、12:00:03〜12:00:07に何らかの欠損があります。
そのため、保存した後にデータをチェックする処理も必要です。
例えば、
for previous, current in zip(data, data[1:]):
    diff = current["timestamp"] - previous["timestamp"]

    if diff > expected_interval:
        print("データ欠損:", previous, current)
のようなチェックを行います。
実際のシステムでは、単純な時間差だけではなく、取引所の仕様やTickデータの性質も考慮する必要があります。
CCXTを使えば全部解決するわけではない
Pythonで暗号資産を扱う場合、CCXTのようなライブラリは非常に便利です。
取引所ごとに異なるAPI仕様を抽象化してくれるため、
import ccxt

exchange = ccxt.example()

ohlcv = exchange.fetch_ohlcv(
    "BTC/USDT",
    timeframe="1m",
    limit=1000
)
のように統一的なインターフェースからOHLCVを取得できます。
ただし、ここでも重要なのは、
CCXTはデータそのものを無制限に保存してくれるサービスではない
という点です。
最終的に取得できる過去データの範囲や件数は、利用する取引所側のAPI仕様などに依存します。
そのため、長期間のデータを取得する場合には、
API取得
↓
ページネーション
↓
次の期間を取得
↓
重複チェック
↓
保存
↓
次の期間
という処理を自分で実装することになります。
Pythonで過去データを集めるならページネーションが必要
例えばAPIが一度に1,000件しか返さないとします。
1分足で100万本必要なら、単純計算でも大量のAPIリクエストが必要です。
イメージとしては、
while True:
    candles = fetch_ohlcv(
        symbol="BTC/USDT",
        timeframe="1m",
        since=since,
        limit=1000
    )

    if not candles:
        break

    save(candles)

    since = candles[-1][0] + 1
のように、取得した最後のデータを基準に次のデータを取得していきます。
秒足やTickデータになると、データ量はさらに増えます。
ここでAPI制限が加わるため、長期間の過去データ収集は想像以上に時間がかかることがあります。
自前取得スクリプト運用とデータセット購入の比較
Pythonで収集システムを作る方法には、もちろんメリットがあります。
自分で仕様を決められますし、リアルタイムデータを継続的に蓄積することもできます。
一方で、「過去データを使って今すぐバックテストしたい」という目的なら、収集基盤をゼロから作ること自体が開発時間の負担になる場合があります。
| 比較項目 | Python自前取得 | 完成済みデータセット |
|---|---|---|
| 初期開発 | 必要 | 基本不要 |
| API仕様への対応 | 必要 | 不要 |
| レート制限対策 | 必要 | 不要 |
| WebSocket再接続処理 | 必要 | 不要 |
| データ欠損チェック | 必要 | データ仕様の確認が必要 |
| サーバー運用 | 必要になる場合あり | 基本不要 |
| 長期間データの蓄積 | 時間がかかる | 購入後に利用可能 |
| データ形式 | 自由に設計可能 | 提供形式に依存 |
| リアルタイム収集 | ○ | 基本的に目的外 |
| 過去データ検証 | 収集期間に依存 | 提供範囲内ですぐ利用可能 |
| 開発工数 | 大きくなりやすい | 小さくしやすい |
| 向いている用途 | 継続的なデータ基盤構築 | 過去データの検証・バックテスト |
ここで重要なのは、どちらが技術的に優れているかではありません。
「自分が何を作りたいのか」です。
リアルタイムデータ収集システムそのものを開発したいのであれば、自前取得には価値があります。
しかし、
自動売買ロジックの開発が目的なのに、データ収集基盤の開発に何日も費やしている
のであれば、一度完成済みデータセットを検討する価値があります。
開発工数も「コスト」として考える
データ収集を自前で行う場合、サーバー代だけを計算してはいけません。
例えば、
API調査
↓
Python取得プログラム作成
↓
ページネーション実装
↓
レート制限対策
↓
WebSocket実装
↓
再接続処理
↓
データ保存
↓
欠損検出
↓
エラー監視
↓
バックアップ
という工程があります。
さらに、実際に運用を開始すると、
「昨日のデータが一部抜けている」
「WebSocketが切断されていた」
「API仕様が変わって動かなくなった」
といった問題への対応も発生します。
エンジニアにとって、ここで見落としやすいのが自分の開発時間そのものの価値です。
サーバー代が月数千円だったとしても、データ収集システムの開発・保守に数十時間かかれば、実質的なコストは大きくなります。
秒足・Tickデータを購入するという選択肢
過去のビットコインデータを使って、
- バックテスト
- 自動売買ロジックの検証
- 約定シミュレーション
- 秒単位の価格分析
- Tickデータ分析
を行いたいのであれば、すでに収集されたデータセットを利用する方法があります。
これは「Pythonでデータを取得できない」という話ではありません。
むしろ、
Pythonで取得する方法を理解したうえで、自分で収集する必要がある部分と、購入して省略できる部分を切り分ける
という考え方です。
自動売買プログラムそのものが研究対象なら、データ収集にかける時間を減らし、バックテストやロジック検証に時間を使うという選択肢があります。
購入したデータはPythonで利用できる
完成済みのデータセットを利用する場合でも、Pythonとの相性は問題になりません。
例えばCSV形式のデータなら、
import pandas as pd

df = pd.read_csv("btc_tick_data.csv")

print(df.head())
print(df.columns)
のように読み込めます。
その後、
df["timestamp"] = pd.to_datetime(df["timestamp"])

df = df.sort_values("timestamp")

print(df)
として時系列データとして処理できます。
バックテストエンジン側では、
データ読み込み
      ↓
時系列順に処理
      ↓
売買条件判定
      ↓
注文生成
      ↓
約定判定
      ↓
手数料・スリッページ計算
      ↓
損益記録
という形にできます。
つまり、データ取得部分を完成済みデータセットに置き換えても、Pythonで作ったバックテストシステム自体はそのまま活用できます。
どちらを選ぶべきか
自前取得が向いているケースは、
- リアルタイムデータを継続収集したい
- 独自フォーマットで保存したい
- データ収集基盤そのものを開発したい
- 自分で取得・監視・バックアップまで管理したい
といった場合です。
一方、完成済みデータセットの利用を検討しやすいのは、
- 過去の大量データをすぐ使いたい
- バックテストを早く開始したい
- APIの過去取得制限に悩んでいる
- WebSocketの切断・再接続処理を作りたくない
- データ収集より売買ロジックの開発に集中したい
といったケースです。
まとめ|Pythonで取得することと、Pythonで分析することを分ける
Pythonは、ビットコインの市場データを扱うための非常に便利な言語です。
REST APIを利用すれば過去データを取得でき、WebSocketを利用すればリアルタイムデータを受信できます。
CCXTなどを利用すれば、取引所APIへのアクセスをある程度簡単にすることもできます。
しかし、長期間のビットコイン 秒足データやTickデータを自前で構築する場合、
- API取得制限
- ページネーション
- レートリミット
- WebSocket切断
- 再接続
- データ欠損
- サーバー運用
- バックアップ
- データ整合性確認
など、多くの処理が必要になります。
そして、これらは自動売買ロジックそのものとは別の開発作業です。
「データ収集基盤を作ること」が目的なら自前取得は有力な選択肢です。
しかし、目的が過去データを使ったバックテストや自動売買システムの検証なら、完成済みのデータセットを利用することで、データ収集部分の開発工数を削減できます。
Pythonでデータを取得する方法を理解したうえで、
「自分で収集する時間」と「購入してすぐ分析する時間」
を比較してみることが重要です。
ビットコインの秒足・Tickデータをすぐに利用したい場合
APIの取得制限やWebSocketの常時接続、サーバー運用を避けて、過去データをバックテストに利用したい場合は、完成済みのデータセットを利用する方法があります。
ビットコインの秒足・Tickデータを探している場合は、以下のデータセットも確認してみてください。
Tick・秒足データ販売:
購入前には、対象銘柄、取引所、データ期間、時間粒度、ファイル形式などが、自分のPython環境やバックテスト仕様に適合するかを確認してください。
データ取得方法そのものを研究する必要がなければ、収集部分を省略して、Pythonによる分析・バックテスト・売買ロジックの検証に開発時間を集中させるという選択肢もあります。
※本記事はプログラミングおよび市場データ収集に関する技術情報を提供するものであり、特定の暗号資産の売買を推奨するものではありません。APIの仕様、取得可能な履歴、レート制限などは取引所によって異なるため、実際に利用するAPIの最新仕様を確認してください。また、過去データによるバックテスト結果は将来の運用結果を保証するものではありません。